ChatGPTを使うと、データベースから必要な情報を取り出すSQLの下書きを作れます。ただし、目的だけを短く伝えて出力をそのまま実行するのは危険です。データベースの種類や表の構造が違えば、正しく動かないことがあります。更新・削除を伴うSQLでは、データを壊すおそれもあります。
初心者は、データベースの種類・テーブル構造・期待する結果を先に整理し、最初はSELECT文だけをテスト環境で試すのが安全です。この記事では、ChatGPTでSQLを作り、結果を確かめるまでを5ステップで説明します。
プログラミング全体でのChatGPTの使い方から知りたい場合は、先にChatGPTでプログラミングする方法を確認してください。
ChatGPTはSQLの「完成品」ではなく下書きを作る道具
SQLは、データベースへ「どの表から、どの条件で、何を取り出すか」を伝える言語です。ChatGPTは日本語の依頼からSQLを作れますが、実際のデータベースを自動で理解しているわけではありません。
| ChatGPTに任せやすいこと | 人が確認すること |
|---|---|
| SQLの下書き | テーブル名・列名が実物と一致するか |
| 各行の意味の説明 | 期待した行と集計結果になるか |
| 別の書き方の提案 | 実行権限と対象環境が安全か |
| エラー原因の候補整理 | 個人情報・機密情報を入力していないか |
MySQL、PostgreSQL、SQLite、BigQueryなどでは、同じ目的でも使える関数や日付処理が異なります。最初に種類を伝えるだけで、使えないSQLが返る可能性を減らせます。
作成前に「SQL依頼カード」を用意する
ChatGPTを開く前に、次の情報をメモします。全部のデータを貼る必要はありません。実在する顧客名やメールアドレスではなく、架空の名前と必要な列だけで十分です。
- データベースの種類:MySQL、PostgreSQL、SQLiteなど
- テーブル名:例
orders - 必要な列:例
customer_id、order_date、amount - 欲しい結果:例「顧客別の9月売上合計」
- 条件:対象期間、除外条件、並び順、表示件数
- 禁止事項:更新・削除をせず、SELECT文だけにする
この依頼カードがあると、ChatGPTとのやり取りが短くなり、修正箇所も見つけやすくなります。実際のファイルを分析したい場合は、個人情報を除いたうえでChatGPTでデータ分析する方法も参考にしてください。
ChatGPTでSQLを作る5ステップ
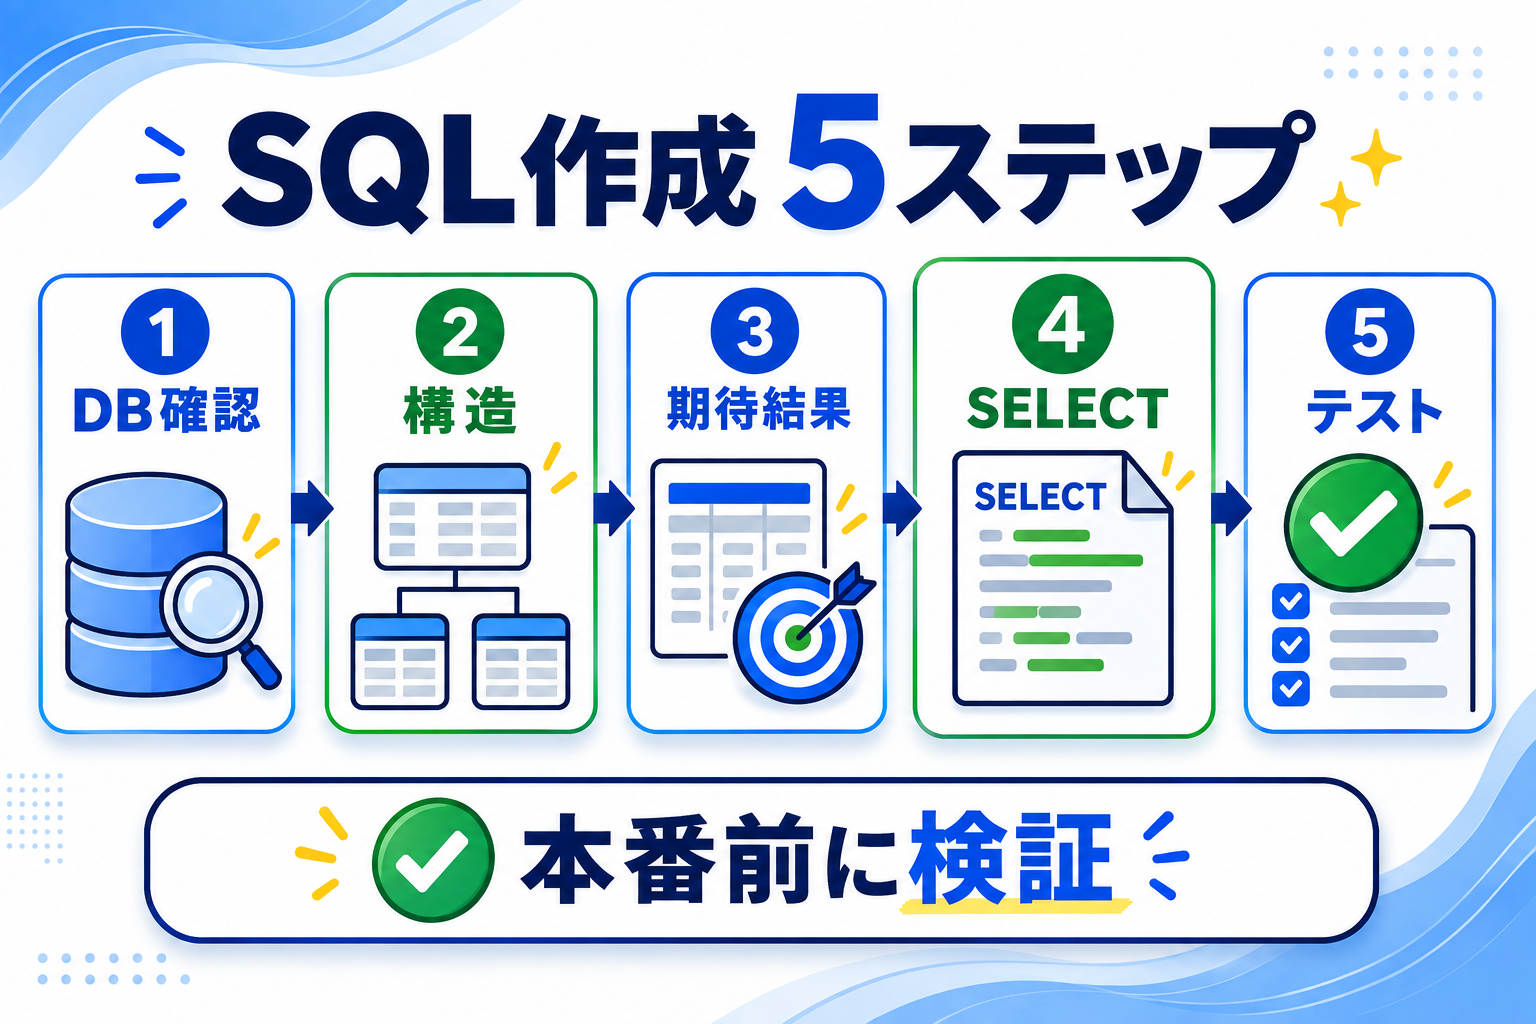
1. データベースの種類を伝える
最初に「MySQL 8で使う」「SQLiteで試す」のように書きます。種類が不明なら、管理画面や担当者へ確認してください。推測したまま進めると、関数や記号の違いでエラーになりやすくなります。
2. テーブル構造を必要最小限で示す
テーブル名、列名、データ型、表同士のつながりを伝えます。顧客情報などの実データは貼らず、次のように架空の構造へ置き換えます。
orders
- order_id: 整数、注文ID
- customer_id: 整数、顧客ID
- order_date: 日付、注文日
- amount: 数値、売上金額
複数の表を使うときは、「orders.customer_id と customers.customer_id が対応する」のように関連も書きます。
3. 期待する結果を具体的に決める
「売上を調べたい」だけでは曖昧です。次の5点まで決めます。
- 表示する列
- 1行が表す単位
- 対象期間や条件
- 並び順
- 最大表示件数
たとえば「2026年9月の売上を顧客ごとに合計し、金額が高い順に20件表示する」と書けば、集計単位と完成形が明確になります。
4. SELECT文だけを作らせ、説明も求める
最初はデータを読むSELECT文に限定します。さらに「各句の役割」「置いた前提」「想定される結果例」も答えさせると、SQLだけが返るより確認しやすくなります。
INSERT、UPDATE、DELETE、DROP、ALTERはデータや構造を変更します。必要性とバックアップ、権限を人が確認できるまでは、生成も実行もしないでください。
5. テスト環境で少件数から試す
いきなり本番データへ実行せず、架空データやテスト用データベースで試します。LIMIT 20などで表示件数を絞り、次を確認します。
- エラーが出ないか
- 期待した列が表示されるか
- 1行の単位が想定どおりか
- 合計や件数を手計算した例と一致するか
- 対象外の期間や行が混ざっていないか
エラーが出たら、データベースの種類、エラー全文、対象部分のテーブル構造を添えて修正を頼みます。ただし、接続情報や実データは貼り付けません。
そのまま使えるSQL作成プロンプト
次のかっこ内を自分の条件へ置き換えて使います。
あなたはSQL作成の補助者です。
次の条件に合うSQLの下書きを作ってください。

データベース:
(ここにMySQL、PostgreSQL、SQLiteなどを入力する)

目的:
(ここに取り出したい結果を入力する)

テーブル構造:
(ここに架空名にしたテーブル名、列名、データ型、表の関連を入力する)

期待する結果:
(ここに表示列、1行の単位、条件、並び順を入力する)

守る条件:
- SELECT文だけを作る
- INSERT、UPDATE、DELETE、DROP、ALTERは使わない
- 表示件数はLIMIT 20で絞る
- 不明な点を推測した場合は、SQLの前に前提を書く
- SQLの各部分を初心者向けに説明する
- 架空データを使った期待結果の例も示す
ChatGPTの出力をさらに確認したいときは、同じ会話で「このSQLが各テーブルへ何をするか、句ごとに説明してください」と質問します。コードの見落としを減らす考え方は、ChatGPTでコードレビューする方法でも解説しています。
顧客別の売上を集計するSQL例
次は、ordersテーブルから2026年9月の売上を顧客別に集計する例です。
SELECT
  customer_id,
  SUM(amount) AS total_amount
FROM orders
WHERE order_date >= '2026-09-01'
  AND order_date < '2026-10-01'
GROUP BY customer_id
ORDER BY total_amount DESC
LIMIT 20;
このSQLでは、対象期間を9月1日以上・10月1日未満にし、customer_idごとにamountを合計しています。最後に合計額の大きい順で20件まで表示します。
ただし、列の型やデータベースの設定によって書き方が変わることがあります。日付に時刻が含まれる場合もあるため、実際の構造を確認してから試してください。
よくある失敗と直し方
| 失敗 | 起こりやすい問題 | 直し方 |
|---|---|---|
| DBの種類を書かない | 関数や日付処理が動かない | 種類と分かればバージョンも伝える |
| 欲しい結果が曖昧 | 集計単位や並び順が違う | 完成後の列と1行の単位を書く |
SELECT *のまま使う |
不要な列や個人情報まで取得する | 必要な列だけ指定する |
| 実データを貼る | 個人情報・機密情報が漏れる | 架空名・ダミーデータへ置換する |
| 変更系SQLを直接実行する | データ消失や誤更新につながる | SELECT限定で検証し、変更は担当者確認後にする |
| 件数を絞らない | 大量読み込みで負荷が増える | 最初はLIMITで少件数にする |
実行前に確認する3つの安全ゲート
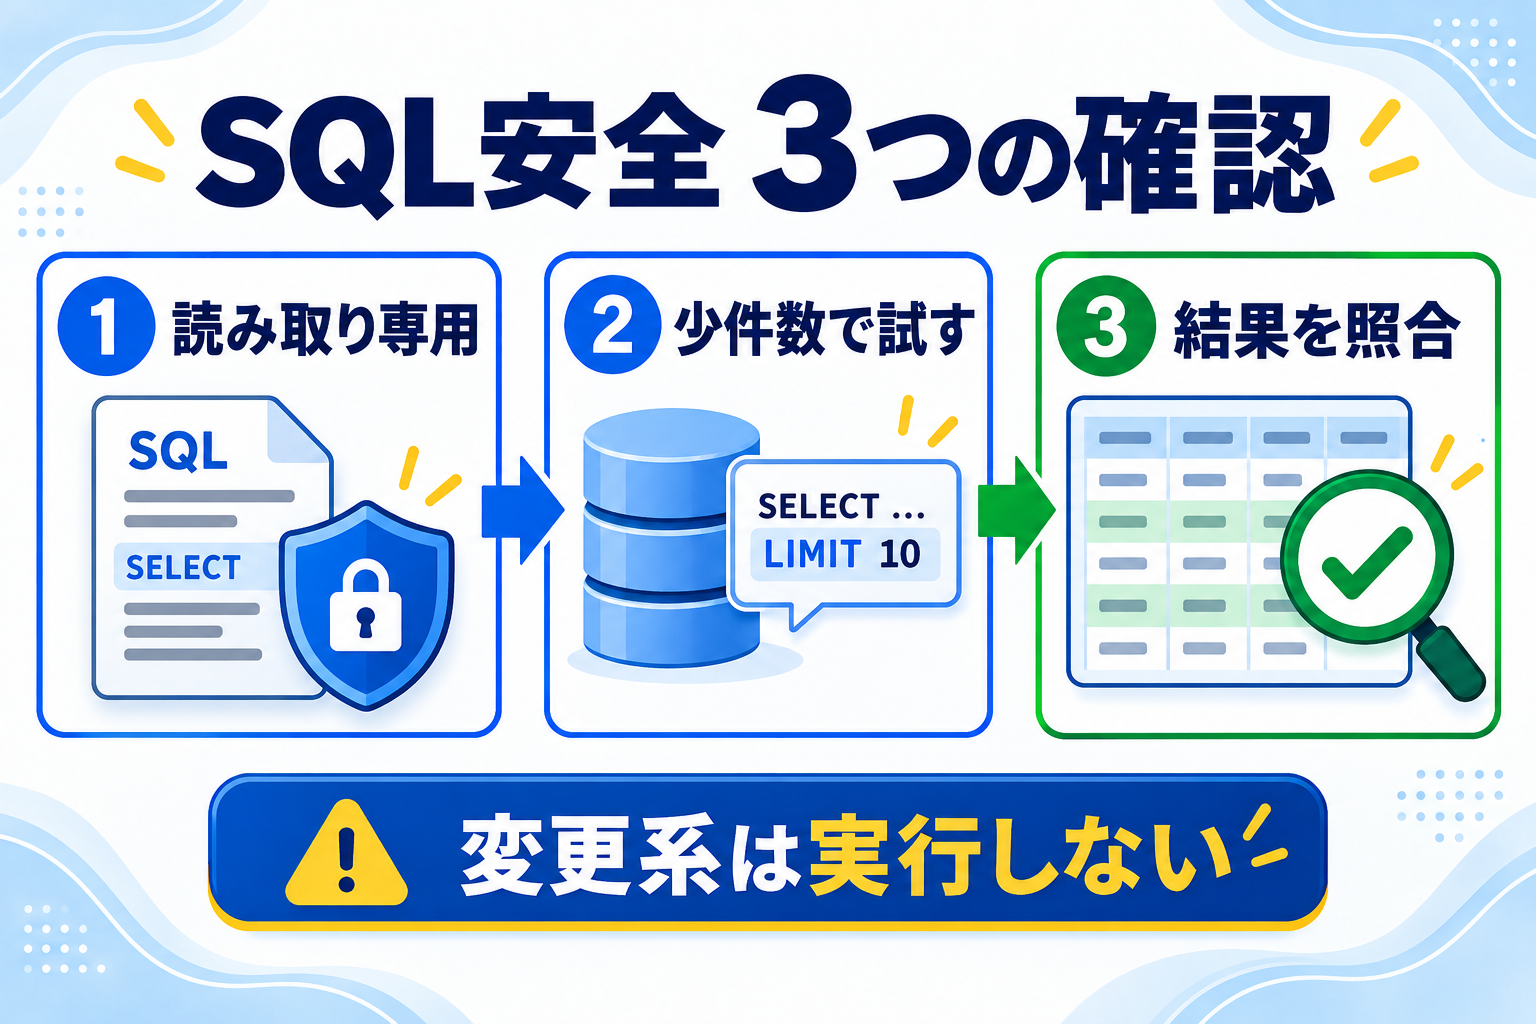
最後に、次の3つがすべて「はい」になってから試します。
- 読み取り専用か:SELECT文だけで、データや表の構造を変えない
- 小さく試せるか:テスト環境・架空データ・少件数で確認できる
- 結果を照合できるか:期待する数行を人が計算し、出力と比べられる
業務データ、顧客情報、接続文字列、パスワードはChatGPTへ入力しません。機密情報を含む可能性がある場合は、組織の利用ルールも確認してください。基本的な注意点はChatGPTを安全に使うための注意点で確認できます。
まとめ
ChatGPTでSQLを作るときは、DB種類、テーブル構造、期待結果を先にそろえることが重要です。生成後は、SELECT文だけかを確認し、テスト環境で少件数から試します。
まずは架空のordersテーブルを用意し、記事のプロンプトへ「顧客別の売上合計を20件表示する」と入力してみてください。SQLを作る速さより、期待結果と照合できる小さなテストを習慣にすることが、安全な活用への近道です。
コメント